Are nevoie România de propriul model de limbaj?
Polonia și Bulgaria și-au făcut deja modele naționale. România are câteva modele deschise făcute de universități, dar niciun proiect național. Am pus față în față argumentele pentru și contra, apoi am spus ce cred eu.
 Andrei NistorJurnalist, fondator aistiri.eu · Story Agents · România
Întrebarea revine de fiecare dată când un vecin anunță „modelul lui”. În februarie 2025, guvernul de la Varșovia a lansat PLLuM, un model de limbaj polonez gratuit, gândit mai ales pentru administrație. În martie 2026, Agenția Națională de Venituri din Bulgaria a început să folosească în toate structurile ei un sistem AI făcut de institutul INSAIT din Sofia. La noi, implementarea RO AI Factory, centrul național de calcul pentru inteligență artificială găzduit de ICI București, a început abia la 1 septembrie, iar centrul ar trebui să funcționeze până la sfârșitul lui 2027.
Nu pornim de la zero. Din mai 2024 există comunitatea OpenLLM-Ro, a Politehnicii din București, a Universității din București și a Institutului de Logică și Știința Datelor, care adaptează pentru română modele deschise precum Llama, Mistral sau Gemma. Tot la Politehnică s-a construit LLMic, un model mic antrenat pentru română. Dar un model național, finanțat public, cu un plan în spate, nu avem.
Am încercat să adun cele mai bune argumente din ambele tabere. Le găsiți mai jos, apoi poziția mea.
Da: de ce ar avea nevoie România de un model al ei
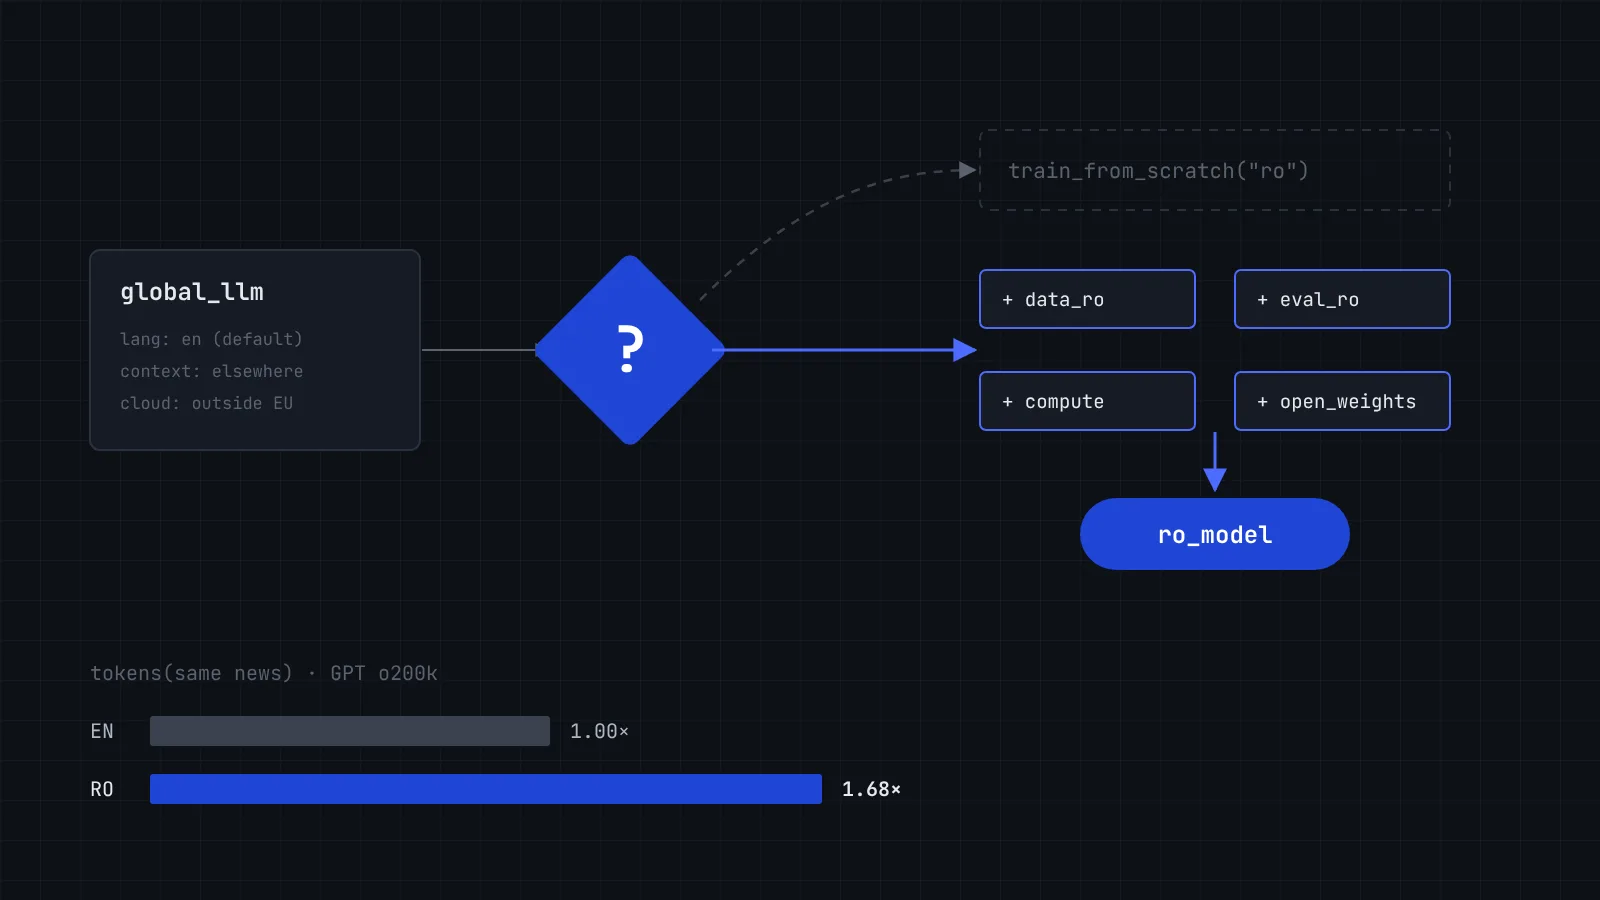
- Limba costă bani. Am măsurat asta în a doua mea lucrare: aceeași știre are nevoie de 1,68 ori mai mulți tokeni în română decât în engleză, cu tokenizerul GPT o200k. Cum plătim pe token, o redacție, o primărie sau o firmă din România plătește mai mult pentru același lucru. Un model construit pentru română poate reduce diferența.
- Contextul nu se traduce. Un model poate scrie o română corectă și totuși să nu știe ce face un consiliu județean sau cum funcționează o instituție de la noi. Echipa OpenLLM-Ro raportează că varianta ei adaptată a modelului Llama 3.1 obține scoruri mai bune decât originalul la un test de cultură românească. Datele din limba ta contează.
- Unele date nu au voie să plece din țară. Spitalele, poliția, instanțele sau multe firme nu pot sau nu vor să trimită documente sensibile într-un cloud din afara Europei. Pentru ele, un model care rulează local nu e un moft, e singura variantă. Compania la care lucrez, Zetta Critical AI din Cluj, a construit ZETTA AI Box tocmai pentru astfel de situații: o platformă AI care rulează complet pe infrastructura clientului, chiar și fără conexiune la internet.
- Vecinii nu stau pe loc. Polonia a alocat pentru PLLuM 14,5 milioane de zloți, plus încă 19 milioane pentru folosirea lui în administrație. Bulgaria a ajuns deja să folosească un model local la fisc. Fiecare an în care România nu face nimic e un an în care alții își construiesc echipe, date și experiență.
Nu: de ce ar fi o investiție greșită
- Scara nu e de partea noastră. Antrenarea modelelor de vârf costă zeci, uneori sute de milioane de dolari, iar ele sunt depășite în câteva luni. Un buget românesc ar produce un model mic, care ar îmbătrâni repede. Riscul e să plătim mult pentru ceva ce un model global va face mai bine peste un an.
- Europa face deja treaba asta. EuroLLM, finanțat de UE, include româna printre cele 35 de limbi pe care le acoperă, iar proiectul OpenEuroLLM, susținut prin programul Europa Digitală, lucrează la modele deschise pentru limbile oficiale ale Uniunii. Chiar în măsurătorile mele, tokenizerii marilor modele multilingve reduc mult costul în plus pentru română: Salamandra ajunge la 1,25.
- „Românesc” nu înseamnă automat „mai bun”. Același model Llama 3.1 adaptat pentru română, care câștigă la cultura românească, pierde mult la un test de răspunsuri pe baza unui text. Iar la un test cu 1.151 de întrebări de gramatică din examenele naționale, modelul Gemma 2 original a obținut un scor mai bun decât variantele lui adaptate pentru română. Adaptarea are un preț, iar el nu se vede din comunicatul de lansare.
- Riscul de vitrină. Un model național poate deveni ușor un proiect de imagine: o conferință de presă, un nume frumos, apoi nicio actualizare. Banii ar putea merge în lucruri mai puțin spectaculoase, dar mai utile.
Ce cred eu: da, dar nu cum crezi
Cred că România are nevoie de un model de limbaj al ei. Dar nu de un „ChatGPT românesc” construit de la zero ca să concureze cu OpenAI. Asta ar fi exact proiectul de vitrină de care se tem criticii, pe bună dreptate.
Ce ne lipsește de fapt e tot ce stă în jurul unui model. Fără astea, orice model românesc va fi slab, iar cu ele, aproape orice model deschis poate deveni bun pentru română. Concret, aș începe cu cinci lucruri:
- Date. Un corpus public, curat și cu licențe clare, în limba română: legislație, documente ale administrației, arhive de presă cedate de redacții, texte educaționale. Datele sunt partea pe care nimeni nu o poate face în locul nostru.
- Măsurătoare. Teste publice pentru română, întreținute constant, care să compare toate modelele pe aceleași probleme. Astăzi nu există un clasament public întreținut care să le compare pe toate. Fără el, discutăm din impresii.
- Acces la calcul. RO AI Factory trebuie să ajungă repede la cercetători, startup-uri și redacții, nu doar la proiectele mari. Abia a început implementarea, deci acum se decide pentru cine va lucra.
- Modele mici, deschise, folosite pe bune. Pentru administrație, sănătate sau presă nu e nevoie de cel mai mare model din lume. E nevoie de modele adaptate, care rulează local și pe care instituțiile le pot verifica. Aici cred că firmele românești pot face diferența.
- Un loc la masa europeană. România ar trebui să fie activă în EuroLLM, OpenEuroLLM și în rețeaua de fabrici AI, ca româna să fie tratată ca limbă de prim rang, nu ca o notă de subsol.
Și ar mai fi un lucru, ieftin și imediat: furnizorii de AI care vând în România să publice cât costă în plus româna față de engleză. E un singur număr și se poate verifica.
Rubrica se numește „Dezbateri” cu un motiv. Dacă ești de altă părere, mai ales dacă lucrezi la un model pentru română sau ai decis să nu-l folosești, scrie-ne. Publicăm replica.
Surse
- Notes from Poland, „Poland launches Polish large language model”, 24 februarie 2025: https://notesfrompoland.com/2025/02/24/poland-launches-polish-large-language-model/
- INSAIT, „The Bulgarian National Revenue Agency Adopts AI by INSAIT”, 19 martie 2026: https://insait.ai/the-bulgarian-national-revenue-agency-adopts-ai-by-insait/
- StartupCafe.ro, despre începerea implementării RO AI Factory, 1 septembrie 2026: https://startupcafe.ro/implementare-proiect-prima-fabrica-inteligenta-artificiala-romania-initiativa-eurohpc-operationala-106132
- Comunicatul de lansare OpenLLM-Ro: https://openllm.ro/comunicat.pdf
- Raportul tehnic OpenLLM-Ro: https://arxiv.org/abs/2405.07703
- Cursuri-AI.ro, „LLM pentru limba română 2026: modele, licențe, benchmark”, 21 octombrie 2026, cu rezultatele comparate ale modelelor: https://cursuri-ai.ro/blog/modele-ai-pentru-limba-romana-2026-openllm-ro-llmic-eurollm-licente-benchmarkuri
- OpenEuroLLM: https://openeurollm.eu/
- ZETTA AI Box: https://zettabox.ai/
- A. Nistor, „The Token Tax in Central and Eastern European Newsrooms”, date și cod: https://doi.org/10.5281/zenodo.23552863
Publicat sub licența CC BY-ND 4.0: poți republica gratuit acest articol, nemodificat, menționând autorul și aistiri.eu.
Republică acest articol
Articolul poate fi republicat gratuit, sub licență Creative Commons. Regulile:
- Textul rămâne neschimbat: fără modificări, tăieri sau traduceri. Poți folosi varianta în română sau pe cea în engleză.
- Menționezi autorul și aistiri.eu, cu link către articolul original.
- Dacă site-ul tău permite, pune linkul canonic spre articolul original.