DiscoveryRSI: Învățare recursivă pentru descoperirea de ipoteze valoroase
Cercetătorii propun DiscoveryRSI, un cadru de lucru care utilizează căutarea evolutivă multi-agent pentru a genera, testa și rafina ipoteze de cercetare, facilitând un proces de descoperire științifică recursiv.
 Andrei NistorJurnalist, fondator aistiri.eu · Story Agents · România
DiscoveryRSI: Recursively Learning to Discover Valuable Hypotheses
Jianyuan Zhong, Chenwei Wu, Zhaochen Yu, Xixian Jiang, Xuewei Li, Hao Xiao și alți 17 autori
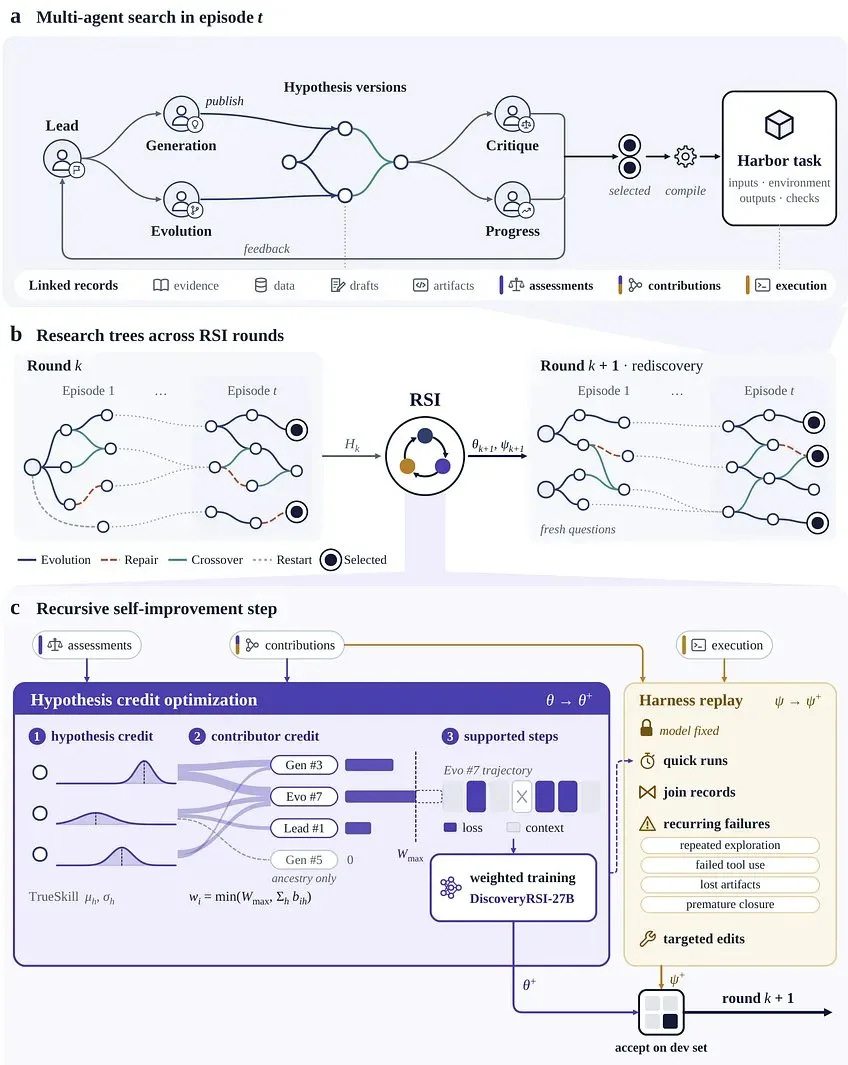
- Metodologie: Sistemul dezvoltă arbori de ipoteze prin căutare evolutivă multi-agent și compilează investigațiile în sarcini Harbor executabile.
- Mecanisme de învățare: Învățarea recursivă este realizată prin optimizarea creditului pentru ipoteze, replay de harness pentru rafinarea fluxurilor de lucru și rediscoverire pentru aplicarea îmbunătățirilor.
- Evaluare: Autorii au introdus DFM-Bench, un instrument pentru evaluarea calității ipotezelor și a progresului cumulativ al cercetării la mai multe niveluri.
- Rezultate: Testele pe patru domenii din life-science arată o creștere a calității ipotezelor și câștiguri semnificative în falsificabilitate și rezolvabilitate de date.
- Comparație: DiscoveryRSI-27B a depășit alte agenți de cercetare în evaluări preliminare umane și în rata de corespondență cu cercetările publicate după data limită a modelului.
Procesul de descoperire științifică implică transformarea unor ipoteze în investigații practice, însă învățarea din acest proces evolutiv este dificilă. DiscoveryRSI abordează această problemă prin definirea ipotezelor ca fiind afirmații bazate pe dovezi despre incertitudini importante, însoțite de investigații fezabile și criterii de decizie explicite.
Sistemul funcționează prin generarea de arbori de ipoteze și utilizarea unor mecanisme de învățare recursivă care permit modelului să identifice strategii productive și să aplice îmbunătățiri la investigații noi. Prin utilizarea DFM-Bench, cercetătorii pot monitoriza progresul cercetării, demonstrând că acest proces de auto-îmbunătățire crește calitatea ipotezelor și capacitatea acestora de a fi testate.
Rezumatul autorilor
Descoperirea științifică necesită dezvoltarea unor ipoteze valoroase în investigații practice, însă învățarea din acest proces de cercetare în continuă evoluție rămâne o provocare. Introducem o definiție operațională pentru ipoteze de cercetare valoroase și testabile: afirmații bazate pe dovezi despre incertitudini cu consecințe, însoțite de investigații fezabile, criterii de decizie explicite și explicații alternative. Cadrul nostru DiscoveryRSI dezvoltă arbori de ipoteze prin căutare evolutivă multi-agent, compilează investigațiile selectate în sarcini Harbor executabile și învață recursiv prin trei mecanisme: optimizarea creditului pentru ipoteze atribuie evaluările științifice contribuțiilor de cercetare documentate; harness replay identifică strategiile productive și eșecurile recurente pentru a rafina fluxurile de lucru de cercetare; și rediscovery aplică îmbunătățirile acceptate la noi investigații, generând experiență suplimentară pentru învățarea ulterioară. Introducem, de asemenea, DFM-Bench, care oferă o evaluare cuprinzătoare a calității ipotezelor și a progresului cumulativ al cercetării la nivelul ipotezelor, al reviziilor, al căilor de dezvoltare și al rulărilor de cercetare. În patru domenii din life-science, evaluarea automată arată că calitatea ipotezelor crește de la 4.86 pentru modelul de bază la 5.39 după două runde de auto-îmbunătățire, cu câștiguri mari în falsificabilitate și rezolvabilitate de date. Validăm în continuare calitatea ipotezelor prin revizuire de către experți, comparând DiscoveryRSI-27B cu alți agenți de cercetare. Evaluările umane preliminare arată că DiscoveryRSI-27B obține scoruri mai mari decât GPT-6 Luna în ceea ce privește importanța ipotezei și dacă afirmațiile sunt plauzibile și limitate de dovezi. DiscoveryRSI-27B a realizat o rată de 6.3% de corespondență a ipotezelor cu cercetările publicate după data limită a modelului, depășind semnificativ GPT-6 cu 2.5% și Claude Opus 5 cu 2.3%, oferind în același timp o îmbunătățire mai mare, evaluată de oameni, de-a lungul căilor de cercetare.
Traducerea în română a rezumatului oficial publicat de autori pe arXiv.
Rezumatul original (engleză)
Scientific discovery requires developing worthwhile hypotheses into practical investigations, yet learning from this evolving research process remains challenging. We introduce an operational definition of valuable and testable research hypotheses: evidence-grounded claims about consequential uncertainties, coupled with feasible investigations, explicit decision criteria, and alternative explanations. Our DiscoveryRSI framework develops hypothesis trees through multi-agent evolutionary search, compiles selected investigations into executable Harbor tasks, and recursively learns through three mechanisms: hypothesis credit optimization attributes scientific assessments to documented research contributions; harness replay identifies productive strategies and recurring failures to refine research workflows; and rediscovery applies accepted improvements to new investigations, generating further experience for subsequent learning. We also introduce DFM-Bench, which provides comprehensive assessment of hypothesis quality and cumulative research progress at the levels of hypotheses, revisions, development paths and research runs. Across four life-science domains, automated evaluation shows that hypothesis quality rises from 4.86 for the base model to 5.39 after two rounds of self-improvement, with the large gains in falsifiability and data resolvability. We further validate hypothesis quality through expert review, comparing our DiscoveryRSI-27B with other research agents. Preliminary human assessments show that DiscoveryRSI-27B scores higher than GPT-6 Luna on hypothesis importance and whether claims are plausible and evidence-bounded. DiscoveryRSI-27B achieved a 6.3% rate of hypothesis correspondence with research published after the model cutoff, largely outperform GPT-6 with 2.5% and Claude Opus 5 with 2.3%, while delivering greater human-rated improvement along research paths.
- arXiv
- 2610.23839
- Publicată pe arXiv
- 20 octombrie 2026
- Licența lucrării
- licența arXiv (toate drepturile la autori)
Lucrarea aparține autorilor. Aici publicăm prezentarea redacției și rezumatul oficial de pe arXiv; textul integral îl găsești pe arXiv.
Surse
- DiscoveryRSI: Recursively Learning to Discover Valuable Hypotheses (arXiv:2610.23839) — arxiv.org
Publicat sub licența CC BY-ND 4.0: poți republica gratuit acest articol, nemodificat, menționând autorul și aistiri.eu.
Republică acest articol
Articolul poate fi republicat gratuit, sub licență Creative Commons. Regulile:
- Textul rămâne neschimbat: fără modificări, tăieri sau traduceri. Poți folosi varianta în română sau pe cea în engleză.
- Menționezi autorul și aistiri.eu, cu link către articolul original.
- Dacă site-ul tău permite, pune linkul canonic spre articolul original.