Taxa pe token: aceeași știre costă mai mult în română decât în engleză
Am măsurat opt tokenizere publice pe texte de știri în română, maghiară și slovacă. Niciunul nu ajunge la egalitate cu engleza, iar presa plătește cel mai mult.
 Andrei NistorJurnalist, fondator aistiri.eu · Story Agents · România
Când o redacție folosește un model de limbaj, plătește pe token. Tokenul e bucata de text cu care lucrează modelul: uneori un cuvânt întreg, alteori o silabă, alteori doar câteva litere. Prețul pe token e același pentru toată lumea. Numărul de tokeni nu e.
Am luat un titlu de știre și l-am trecut prin același tokenizer, GPT o200k, în patru limbi. În engleză a avut 18 tokeni. În română, 27. În maghiară, 28. În slovacă, 33. Aceeași știre, altă factură.
Un exemplu nu dovedește nimic, așa că am făcut măsurătoarea cum trebuie. Rezultatul e a doua mea lucrare, „The Token Tax in Central and Eastern European Newsrooms”.
Ce am măsurat
Am testat opt tokenizere publice, de la cele folosite de modelele GPT la cele ale unor modele construite în Europa. Le-am aplicat pe 960 de segmente de text paralele, adică același conținut tradus în fiecare limbă, și pe 479 de articole reale de presă în română, maghiară și slovacă. Pentru fiecare combinație am calculat de câte ori mai mulți tokeni îi trebuie unei limbi decât englezei ca să spună același lucru.
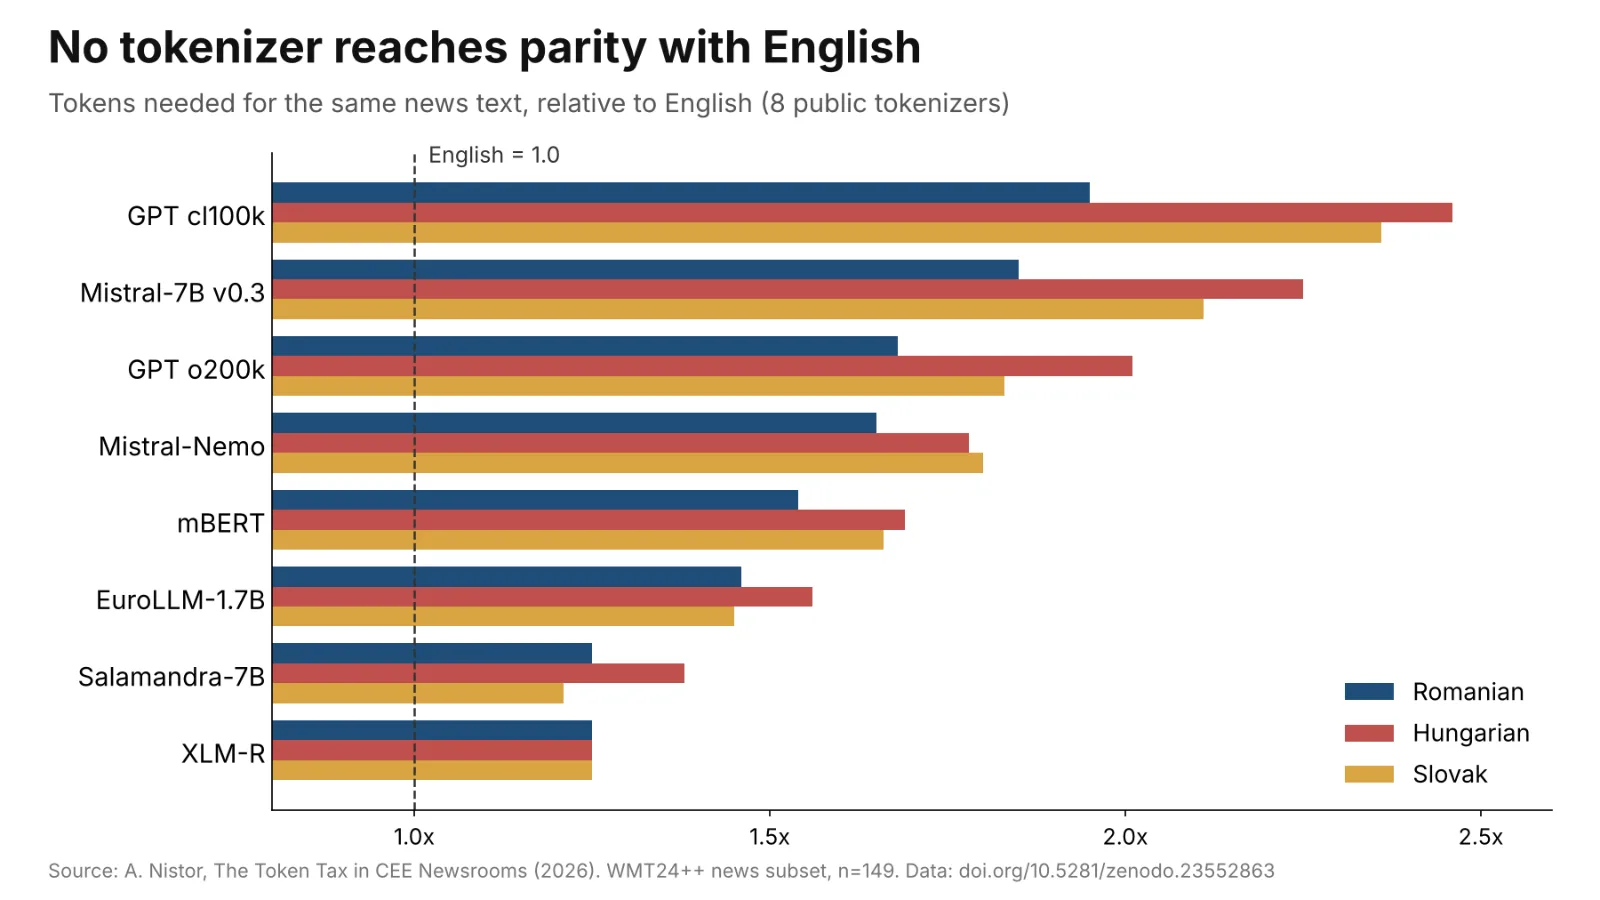
Pentru textele de știri, cifrele arată așa (engleza = 1):
- GPT cl100k: română 1,95, maghiară 2,46, slovacă 2,36
- Mistral-7B v0.3: română 1,85, maghiară 2,25, slovacă 2,11
- GPT o200k: română 1,68, maghiară 2,01, slovacă 1,83
- Mistral-Nemo: română 1,65, maghiară 1,78, slovacă 1,80
- mBERT: română 1,54, maghiară 1,69, slovacă 1,66
- EuroLLM-1.7B: română 1,46, maghiară 1,56, slovacă 1,45
- Salamandra-7B: română 1,25, maghiară 1,38, slovacă 1,21
- XLM-R: 1,25 în toate trei limbile
Concluzia scurtă: niciun tokenizer nu ajunge la paritate cu engleza. Nici unul.
Ce înseamnă asta pentru o redacție
Să luăm tokenizerul GPT o200k, folosit de modele foarte răspândite. Aceeași știre are nevoie de 1,68 ori mai mulți tokeni în română, de 2,01 ori în maghiară și de 1,83 ori în slovacă. Cum prețul pe token e același, același buget cumpără unei redacții din regiune cam între jumătate și 60% din ce cumpără unei redacții de limbă engleză.
Banii sunt doar o parte. Fiecare model are o „fereastră de context”, adică o limită a textului pe care îl poate citi deodată. Dacă maghiara consumă de două ori mai mulți tokeni, o redacție maghiară încape în aproximativ jumătate din spațiul pe care îl are o redacție engleză. Asta înseamnă mai puține documente-sursă de pus lângă draft și mai puțin material față de care să verifici ce a scris modelul. Taxa pe token lovește, așadar, și în calitate, nu doar în buget.
Un lucru m-a surprins. Am comparat mai multe tipuri de text, iar știrile au fost cel mai scump registru în toate cele trei limbi, la toți tokenizerii testați. Altfel spus, testele construite pe text general subestimează exact costul plătit de presă.
Ajută modelele europene?
Da, dar nu rezolvă problema. Tokenizerii modelelor multilingve mari reduc mult diferența: Salamandra coboară la 1,21–1,38, iar XLM-R ajunge la 1,25 în toate trei limbile. Totuși, niciunul nu atinge egalitatea cu engleza.
Și mărimea vocabularului nu explică totul. Mistral-Nemo și EuroLLM au vocabulare de dimensiuni foarte apropiate și rezultate foarte diferite. Contează felul în care a fost construit vocabularul și din ce texte, nu doar cât de mare e.
Ce poți face concret
- Măsoară înainte să alegi. Înainte de a lega o redacție de un model, verifică de câți tokeni are nevoie pe textele tale reale, nu pe exemplele din documentație.
- Compară tokenizerii, nu doar prețul pe token. Un preț mai mic pe token poate ieși mai scump dacă modelul îți taie limba în bucăți mai mici.
- Folosește datele deschise. Datele și codul din studiu sunt publice, sub licențe deschise (cod MIT, date CC BY 4.0), pe Zenodo: https://doi.org/10.5281/zenodo.23552863. Le poți rula pe propriile articole.
Rămâne întrebarea cine ar trebui să publice cifrele astea în mod obișnuit. Eu cred că furnizorii de AI, iar despre asta e ultimul articol din serie.
Publicat sub licența CC BY-ND 4.0: poți republica gratuit acest articol, nemodificat, menționând autorul și aistiri.eu.
Republică acest articol
Articolul poate fi republicat gratuit, sub licență Creative Commons. Regulile:
- Textul rămâne neschimbat: fără modificări, tăieri sau traduceri. Poți folosi varianta în română sau pe cea în engleză.
- Menționezi autorul și aistiri.eu, cu link către articolul original.
- Dacă site-ul tău permite, pune linkul canonic spre articolul original.