Un model AI poate scrie o română impecabilă și tot să nu înțeleagă România
Decalajul lingvistic al modelelor de limbaj nu se vede în gramatică. Se vede în fapte, în context și în întrebarea cine are dreptul să verifice. De aici am pornit când am propus cadrul Echitate Mediatică Lingvistică.
 Andrei NistorJurnalist, fondator aistiri.eu · Story Agents · România
Cine a lucrat cu un model de limbaj în română cunoaște senzația. Textul curge, diacriticele sunt la locul lor, frazele sună a presă. Și totuși ceva nu se leagă. O instituție primește atribuții pe care nu le are. Un citat sună plauzibil, dar nimeni nu și-l amintește. Un eveniment local e povestit ca și cum s-ar fi întâmplat într-un oraș american.
Am vrut să înțeleg de unde vine diferența asta, așa că am scris despre ea o lucrare științifică: „The LLM Language Divide”, pe care am prezentat-o anul acesta la conferința TRUST 2026. Concluzia ei e simplă de spus și greu de reparat. Modelele de limbaj nu funcționează la fel de bine în toate limbile, iar pentru presă diferența contează mai mult decât pentru oricine altcineva.
De unde vine decalajul
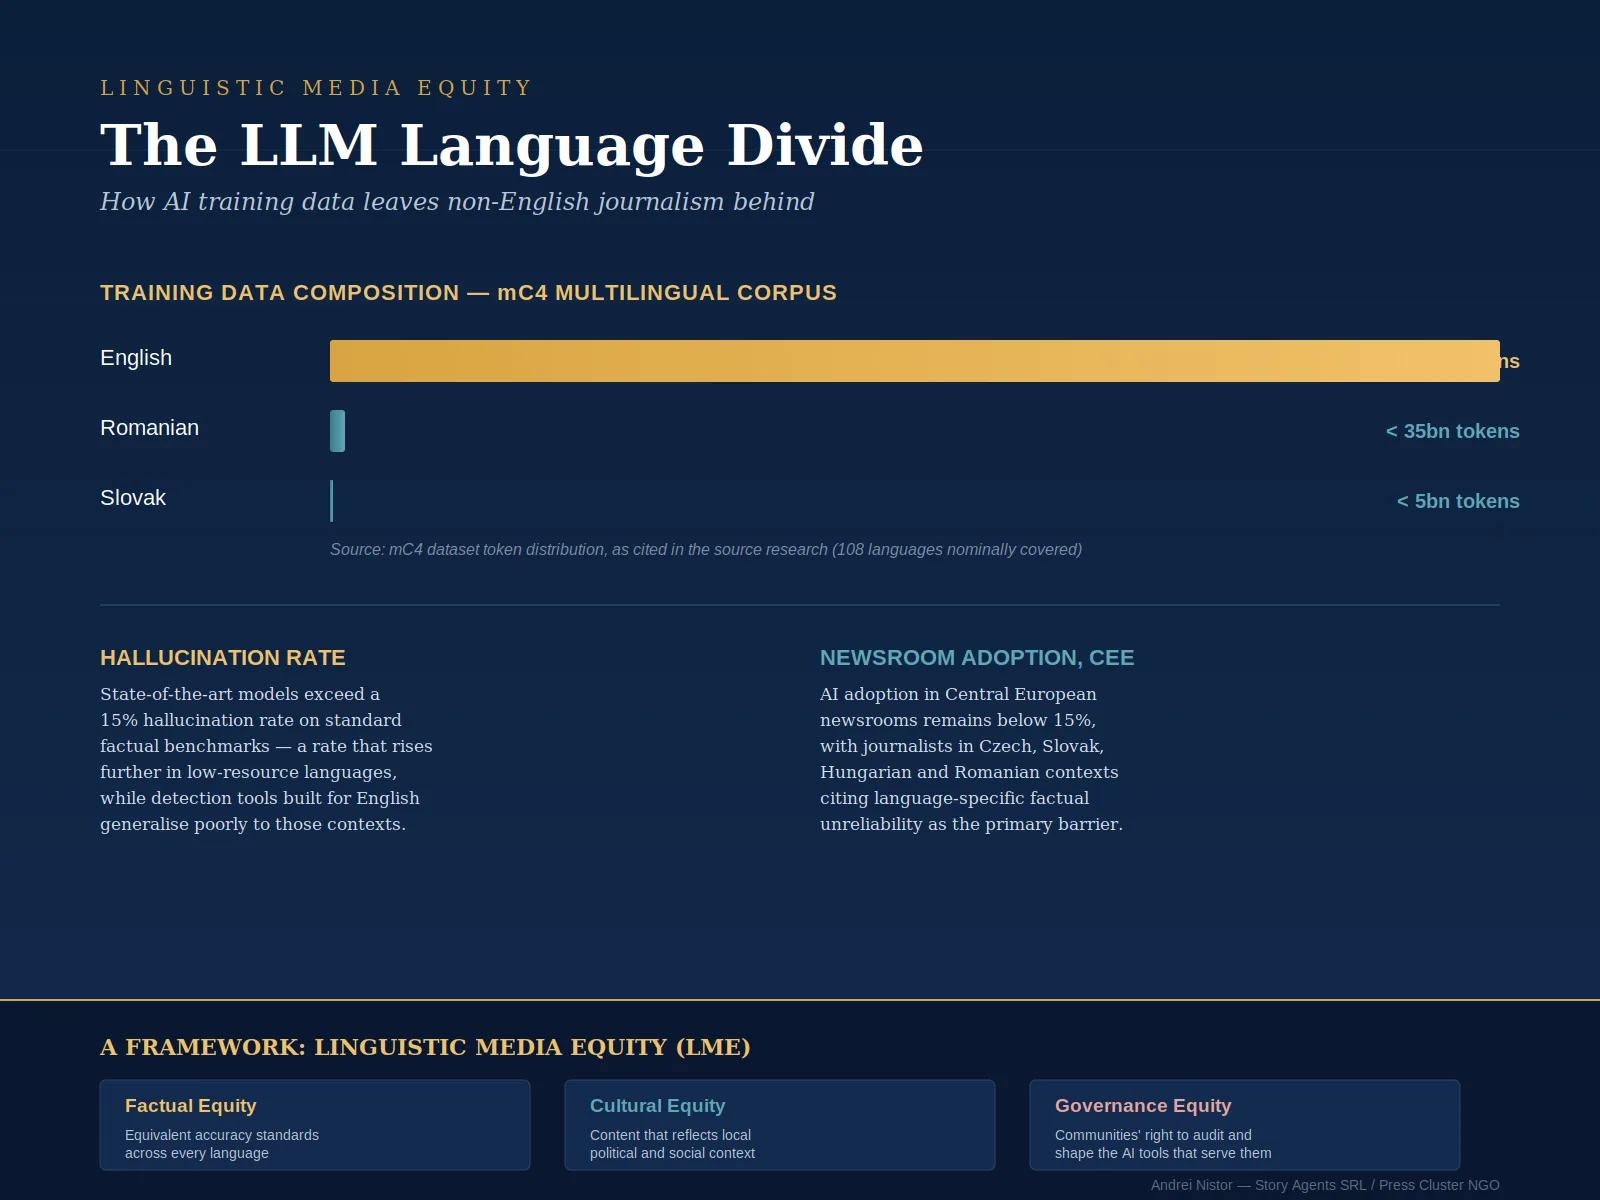
Un model de limbaj învață din textele pe care le-a văzut la antrenare. Le vede pe toate, dar nu în proporții egale. Engleza domină covârșitor corpusurile pe care sunt antrenate marile modele. Româna, maghiara, slovaca sau bulgara, deși sunt limbi oficiale ale Uniunii Europene vorbite de milioane de oameni, ocupă acolo doar fracțiuni mici.
Consecința nu e doar că modelul știe mai puține cuvinte românești. E mai subtilă. Gramatica se transferă relativ ușor de la o limbă la alta. Contextul nu. Un model poate construi corect o frază despre un consiliu județean fără să știe ce face de fapt un consiliu județean. Literatura de specialitate are o expresie pentru asta, pe care am preluat-o în lucrare: modelele vorbesc cu „accent american”, indiferent de limba în care le scrii.
Mai e un strat, pe care îl tratăm de obicei ca pe o chestiune tehnică: felul în care modelul taie textul în bucăți, adică tokenizarea. Despre el scriu separat, în articolul următor, pentru că acolo am avut ce măsura.
Trei feluri în care greșește un model, în redacție
Într-o conversație obișnuită, o eroare a unui chatbot e o neplăcere. Într-o știre, e o problemă publică. În lucrare am descris trei tipuri de greșeli care contează în mod special pentru presă.
- Citatul inventat. Modelul atribuie unui politician sau unui purtător de cuvânt o frază pe care acesta nu a spus-o niciodată. Cu cât modelul cunoaște mai puțin discursul public dintr-o țară, cu atât îi e mai ușor să „completeze” plauzibil.
- Instituția greșită. Numele sunt corecte, dar atribuțiile, competențele sau relațiile dintre instituții sunt inventate. E eroarea cea mai greu de prins pentru cititor, pentru că totul arată credibil.
- Contextul strâmb. Textul e corect gramatical, dar privește evenimentele prin ochelarii altei culturi politice. Un fact-checker automat nu are cum să prindă asta.
Partea neplăcută vine abia acum. Instrumentele care detectează automat halucinațiile modelelor funcționează și ele mai prost în limbile mai mici. Competiția științifică Mu-SHROOM, organizată în 2025 tocmai pentru detectarea halucinațiilor în mai multe limbi, a arătat că metodele bune pentru engleză nu se transferă la fel de bine în alte limbi. Așa că redacțiile din regiune primesc două dezavantaje odată: modele care greșesc mai des și unelte care prind mai greu greșelile.
Ce înseamnă Echitate Mediatică Lingvistică
Dacă problema e structurală, are nevoie și de un reper. În lucrare am propus unul și i-am spus Echitate Mediatică Lingvistică. Ideea e următoarea: o comunitate are dreptul la jurnalism asistat de AI care respectă aceleași standarde de acuratețe, autenticitate culturală și fiabilitate editorială, indiferent de limba în care e produs. Iar când aceste standarde nu sunt atinse în mod repetat într-o limbă, nu mai vorbim de un defect tehnic, ci de o inegalitate în accesul la informație.
Cadrul are trei dimensiuni.
- Echitatea factuală. Un instrument AI folosit în română ar trebui să aibă aceeași rată de erori factuale ca în engleză. Dacă nu are, limitele trebuie spuse deschis și gestionate de redacție.
- Echitatea culturală. Instrumentul trebuie să înțeleagă cultura politică, instituțiile și memoria comunității pentru care scrie. Asta nu se obține doar prin traducere.
- Echitatea în guvernanță. Comunitățile au dreptul să verifice cum se comportă aceste sisteme în limba lor, să afle din ce date au învățat și să aibă un cuvânt de spus în felul în care sunt folosite.
Ce poate face o redacție de mâine
Nu cred că soluția e să renunțăm la AI. Redacțiile mici din regiune sunt exact cele care au cea mai mare nevoie de ajutor și cele mai puține resurse. Dar putem lucra cu ochii deschiși. Citatele, numele instituțiilor și atribuțiile lor sunt locurile în care modelele greșesc cel mai ușor în limba noastră, deci acolo trebuie să stea verificarea umană. Iar un text care „sună bine” nu e, prin asta, un text corect.
Lucrarea e doar începutul. Următorul pas a fost să trec de la argument la măsurătoare, iar prima dimensiune pe care am putut-o măsura cu cifre a fost costul. Despre asta e articolul următor din serie.
Publicat sub licența CC BY-ND 4.0: poți republica gratuit acest articol, nemodificat, menționând autorul și aistiri.eu.
Republică acest articol
Articolul poate fi republicat gratuit, sub licență Creative Commons. Regulile:
- Textul rămâne neschimbat: fără modificări, tăieri sau traduceri. Poți folosi varianta în română sau pe cea în engleză.
- Menționezi autorul și aistiri.eu, cu link către articolul original.
- Dacă site-ul tău permite, pune linkul canonic spre articolul original.